
Claude Sonnet 5.5: що змінилося? Порівняння з Sonnet 5 та Opus 5.5
Claude Sonnet 5.5: майже Opus, але дешевше на задачу
Anthropic випустила Claude Sonnet 5.5 — другу модель у лінійці Claude 5.5 після Opus 5.5. Компанія робить ставку не на зниження ціни за токен, а на іншу економіку: Sonnet 5.5 має працювати швидше, витрачати менше токенів і робити менше викликів інструментів.
За даними Anthropic, модель генерує відповіді більш ніж на 30% швидше за Sonnet 5, а в її внутрішніх тестах вартість виконання задачі знизилася до 30%. При цьому базова API-ціна залишилася тією самою — $2 за 1 млн вхідних токенів і $10 за 1 млн вихідних.
І саме тут Sonnet 5.5 стає цікавим: за низкою тестів він уже підбирається до значно дорожчого Opus 5.5.
Sonnet 5.5 проти Sonnet 5: стрибок набагато більший, ніж здається
Якщо дивитися лише на прайс, оновлення може здатися не надто вражаючим. Ціна Sonnet не змінилася.
А ось результати тестів змінилися суттєво.
В агентному coding-бенчмарку Terminal-Bench 4.0 Anthropic заявляє 70,6% для Sonnet 5.5 проти 10,3% у Sonnet 5. У CursorBench 4.0 — 55,5% проти 34,1%, а в OSWorld 2.1, який оцінює роботу моделі з комп'ютером, — 80,1% проти 57%.
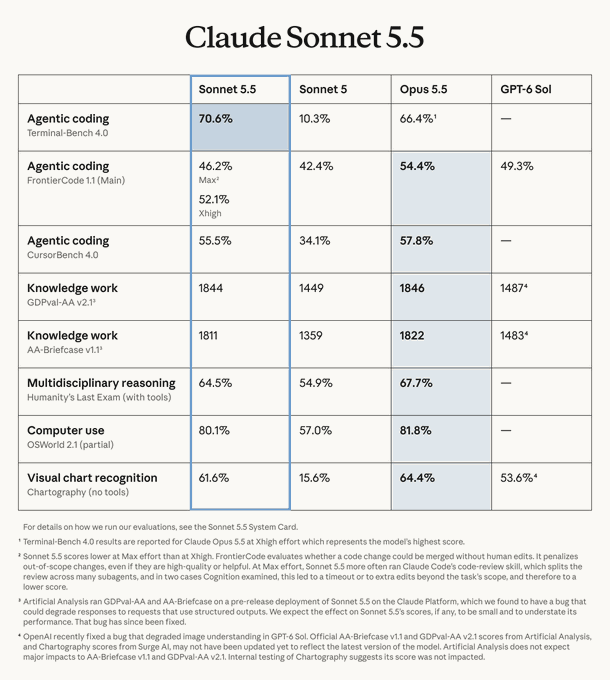
Claude: Sonnet 5.5; Sonnet 5; Opus 5,5; GPT-6 Sol.
* Для Opus 5.5 Anthropic наводить результат Terminal-Bench на найвищому Xhigh effort. Тому порівнювати його із Sonnet без урахування режиму reasoning не зовсім коректно.
Найцікавіше тут навіть не те, що Sonnet 5.5 випереджає попередника.
А те, наскільки близько він підійшов до Opus 5.5.
Sonnet уже наступає Opus на п'яти
На GDPval-AA різниця між моделями становить лише два пункти: 1844 проти 1846.
На OSWorld — 80,1% проти 81,8%.
У CursorBench — 55,5% проти 57,8%.
Тобто в частині практичних агентних і робочих сценаріїв розрив між двома моделями став дуже невеликим.
А на Terminal-Bench 4.0 у наведеному Anthropic тесті Sonnet 5.5 взагалі отримав 70,6% проти 66,4% у Opus 5.5.
Але з цього не випливає, що Sonnet 5.5 «переміг» Opus.
Різні бенчмарки перевіряють різні навички, а результат сильно залежить від рівня effort, набору інструментів і конкретної методики тестування.
Це добре видно на FrontierCode.
Максимальний reasoning не завжди дає максимальний результат
У FrontierCode 1.1 Sonnet 5.5 показав 46,2% на Max і 52,1% на Xhigh.
На перший погляд це дивно: чому модель із більшим рівнем effort отримує гірший результат?
Anthropic пояснює це особливістю самого тесту. На Max Sonnet 5.5 частіше запускав code-review через кількох субагентів. У частині випадків це призводило до таймаутів або змін за межами початкового завдання.
А FrontierCode карає модель за такі out-of-scope зміни, навіть якщо вони самі по собі якісні.
Це хороший приклад того, чому одна цифра в таблиці не розповідає всієї історії про модель.
Де тут економія, якщо ціна за токен не змінилася?
Ось, мабуть, найважливіша частина релізу.
Sonnet 5.5 коштує стільки ж, скільки Sonnet 5:
- $2 / 1M input tokens;
- $10 / 1M output tokens;
- $0,20 / 1M cache reads.
Для Opus 5.5 ціни становлять $4 / 1M input і $20 / 1M output.
Але Anthropic стверджує, що Sonnet 5.5 для виконання тієї самої роботи зазвичай потребує менше токенів. Також модель може виконувати завдання за меншу кількість tool calls.
Тому «до 30% дешевше» — це не знижка на токен.
Це оцінка вартості завершеної задачі порівняно із Sonnet 5.
І це принципово різні речі.
Найцікавіше починається на реальних задачах
Незалежні вимірювання Artificial Analysis показують, чому з цією заявою варто бути обережним.
На їхньому Intelligence Index Sonnet 5.5 на максимальному effort отримав 56 балів — лише на два менше за Opus 5.5.
Але при цьому Sonnet 5.5 витрачав близько 193 тисяч вихідних токенів на задачу — більше, ніж Opus 5.5 у цьому вимірюванні. За розрахунками Artificial Analysis, середня вартість задачі на їхньому індексі становила близько $7,60 для Sonnet 5.5 проти $5,98 для Opus 5.5.
І ось тут ламається проста формула:
дешевший токен ≠ дешевша готова задача.
Якщо модель витрачає набагато більше токенів заради кращого результату, кінцевий рахунок може виявитися зовсім іншим.
Водночас це вимірювання Artificial Analysis на максимальному effort, тоді як Anthropic робить значну частину своїх заяв про ефективність на нижчих рівнях effort. Тому обидва набори цифр можуть бути правильними одночасно — вони просто відповідають на різні запитання.
А що з 1 млн токенів контексту?
Sonnet 5.5 отримав контекстне вікно до 1 млн токенів і до 128 тисяч токенів вихідного контексту. Це робить модель особливо цікавою для великих кодових баз, довгих документів і агентних сценаріїв, де модель повинна працювати з великим обсягом інформації за один цикл.
Але великий контекст сам по собі не гарантує хорошого результату.
Для розробника важливіше інше: наскільки добре модель знаходить потрібну інформацію, не губить залежності між файлами та здатна довести задачу до робочого стану.
Саме тому реальні coding-сценарії можуть бути інформативнішими за красиву таблицю бенчмарків.
Для кого Sonnet 5.5?
Anthropic позиціонує Sonnet 5.5 як модель для добре окреслених повсякденних задач: програмування, виправлення багів, створення документів, презентацій, таблиць та роботи з інтерфейсами.
Opus 5.5 компанія залишає для складнішої, неоднозначної роботи, де потрібні тривале міркування та постійне прийняття рішень.
Тобто логіка лінійки стає приблизно такою:
Sonnet 5.5 — швидка робоча конячка для великої кількості типових задач.
Opus 5.5 — дорожчий варіант для задач, де важливі глибина, автономність і робота з неоднозначністю.
Причому межа між ними стала значно меншою.
Що це означає для розробників
Найцікавіша зміна може бути не в самих benchmark-таблицях, а в економіці агентного програмування.
Якщо модель може виконувати типову coding-задачу за меншу кількість кроків, швидше проходити цикл «написав → перевірив → виправив» і рідше викликати інструменти, то навіть незмінна ціна токенів може означати менший рахунок за готовий результат.
Але це потрібно перевіряти на власному workload.
Одна кодова база може показати зовсім іншу картину, ніж Terminal-Bench або GDPval.
Тому для команд, які вже використовують Claude Code або інші coding agents, найцікавіший експеримент простий: взяти однаковий набір реальних задач, прогнати його через Sonnet 5.5 та Opus 5.5 на однакових рівнях effort і порахувати не токени, а вартість завершеної задачі та кількість невдалих ітерацій.
Sonnet 5 тепер можна списувати?
Не зовсім.
Але після виходу Sonnet 5.5 його переваг стає значно менше. Новинка зберігає ту саму базову ціну, але суттєво підвищує продуктивність у низці тестів. Anthropic прямо називає Sonnet 5.5 чітким апгрейдом порівняно із Sonnet 5.
Для нових проєктів логічніше спочатку перевіряти саме 5.5.
А от у вже налаштованих production-системах міграцію все одно варто оцінювати на власних даних: важливі не лише benchmark-бали, а стабільність, latency, кількість tool calls, витрати та частота помилок.
P.S.
Claude Sonnet 5.5 — не просто швидша версія Sonnet 5.
Anthropic фактично підтягує свій середній клас дуже близько до Opus у частині coding, computer use та knowledge-work задач. При цьому ціна за токен не зросла, а заявлена економія до 30% стосується вартості виконання задачі, а не самого API-прайсу.
Але є важливе «але».
Незалежні тести показують, що на максимальному effort Sonnet 5.5 може витрачати дуже багато токенів, а тому дешевший прайс за мільйон токенів не гарантує дешевшого результату.
Тому головне питання після релізу звучить уже не «Sonnet чи Opus?», а:
скільки реально коштує виконати мою конкретну задачу кожною моделлю — і скільки часу це займає?
Саме це варто перевірити на власному коді, документах та агентних сценаріях.
А тим часом Anthropic уже готує Haiku 5.5, який, за словами компанії, має приєднатися до лінійки найближчими тижнями.